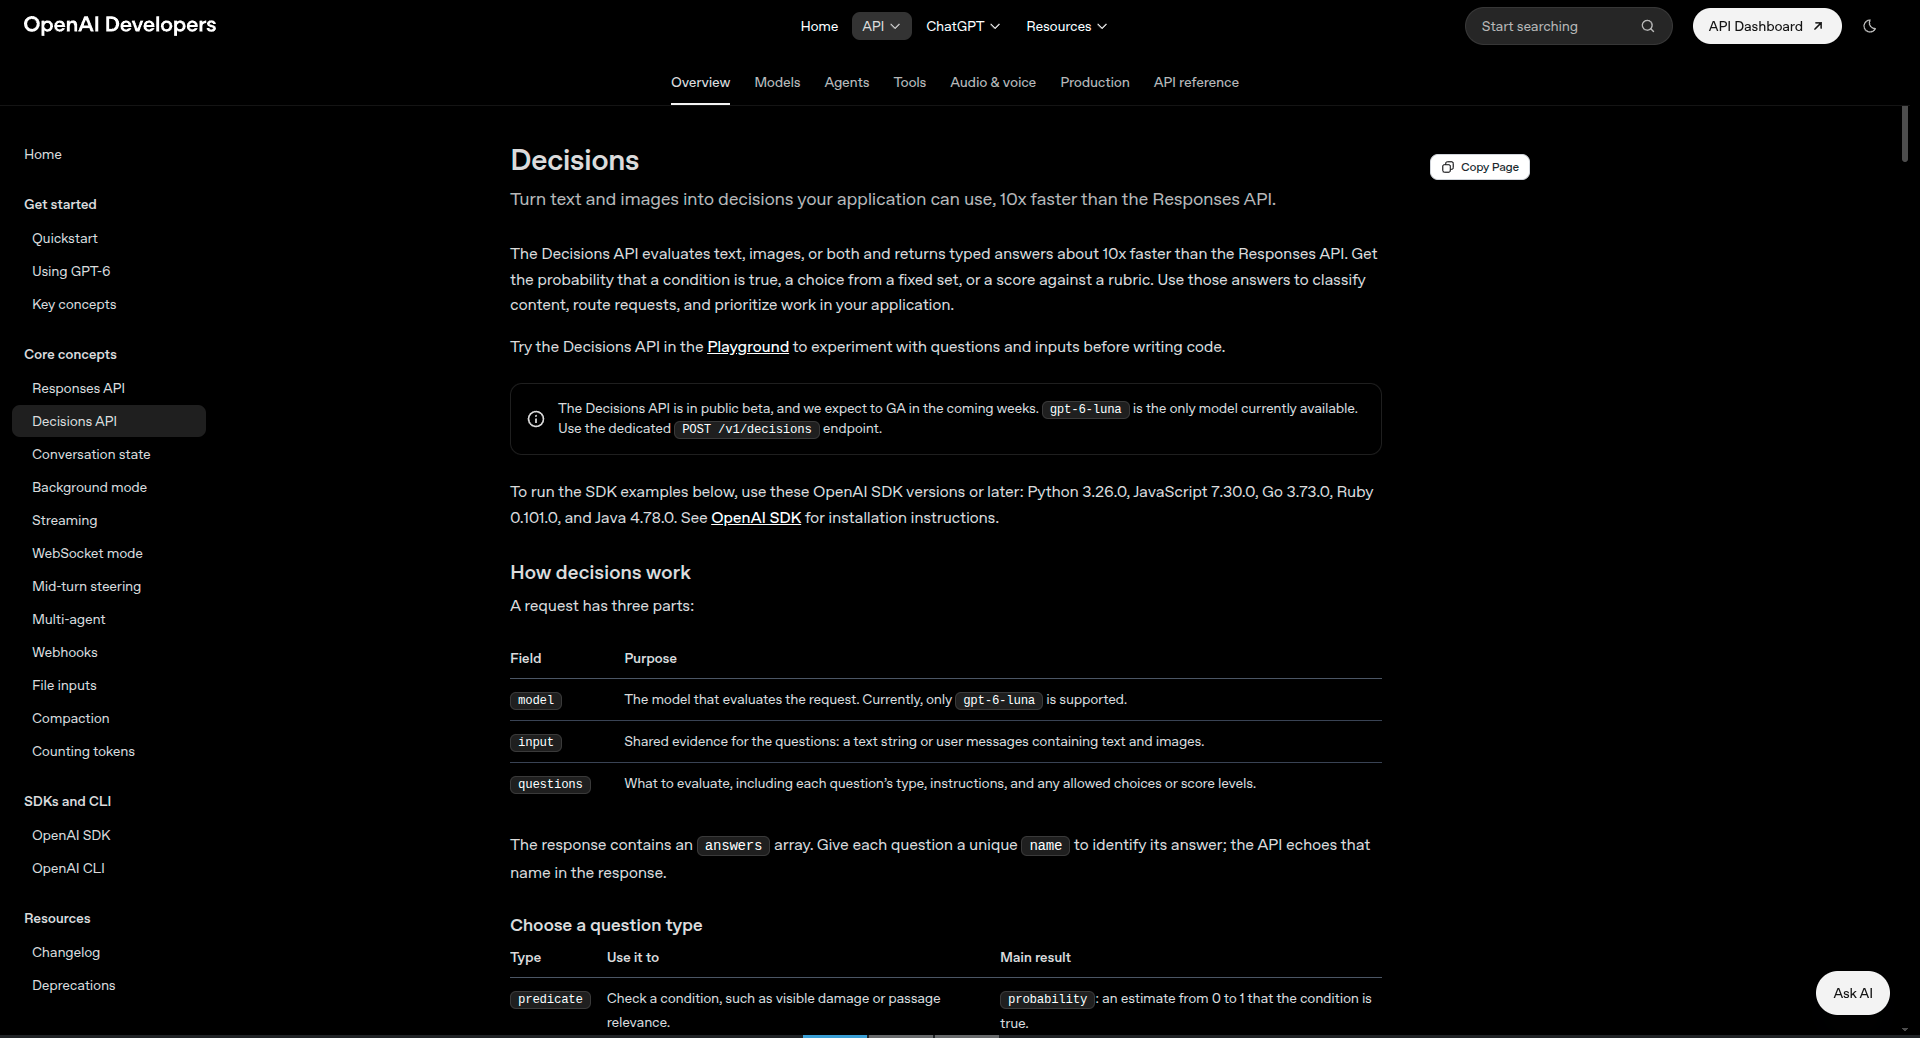
TL;DR: Pada 6 Oktober 2026 OpenAI merilis Decisions API dalam public beta — endpoint POST /v1/decisions yang mengembalikan verdict terstruktur (probabilitas, pilihan, atau skor) alih-alih teks prosa, hanya berjalan di model gpt-6-luna, diklaim ~10x lebih cepat dari Responses API, dan hanya menagih token input ($0,10 per 1 juta token; output gratis). Artikel ini adalah tutorial praktis: cara kerja tiga tipe pertanyaannya, contoh kode Node.js dan Python untuk triase tiket, moderasi gambar, dan severity scoring, hitung-hitungan biaya versus pendekatan lama, plus kapan sebaiknya Anda tidak memakainya.
Masalah yang Mungkin Anda Alami Setiap Hari
Bayangkan skenario yang sangat umum di backend aplikasi AI. Pengguna mengunggah foto produk dan mengklaim barangnya rusak. Anda perlu memutuskan: apakah foto ini benar-benar menunjukkan kerusakan? Atau skenario lain: tiket support masuk, Anda perlu me-routing-nya ke tim billing, teknis, atau akses akun. Atau: seberapa parah insiden keamanan ini dalam skala 1–5?
Cara mayoritas developer menyelesaikan ini hari ini adalah dengan memanggil chat model dan menulis prompt seperti:
"Jawab hanya dengan JSON: {"rusak": true/false}. Jangan tambahkan penjelasan."
Lalu di kode, Anda me-regex atau JSON.parse hasilnya, berharap model tidak memutuskan untuk bersikap "membantu" dengan menambahkan "Tentu! Berikut analisis saya..." sebelum JSON-nya. Kalau pernah debugging pipeline yang rusak karena model tiba-tiba menambahkan kalimat pembuka, Anda tahu persis rasa sakitnya.
Ini bukan cuma soal kerapian. Ada tiga biaya nyata dari pola "prompt-chat-untuk-keputusan":
- Latensi: model tetap men-generate token demi token — reasoning chain, kata pengantar, formatting — padahal yang Anda butuhkan cuma satu nilai.
- Biaya: setiap token output ditagih. Untuk klasifikasi bervolume tinggi, token output yang tidak pernah dibaca manusia adalah uang yang dibakar.
- Kerapuhan: parsing teks bebas adalah sumber bug yang tidak pernah benar-benar hilang. Structured Outputs membantu, tapi tetap men-generate JSON token per token.
Decisions API adalah jawaban OpenAI untuk ketiga masalah itu: sebuah endpoint khusus yang tidak mengembalikan teks sama sekali — hanya verdict yang bisa langsung di-branch oleh kode Anda.
Apa Sebenarnya Decisions API Itu
Decisions API adalah endpoint terpisah di OpenAI API — POST /v1/decisions — yang dirilis dalam public beta pada 6 Oktober 2026 (sebelumnya muncul sebagai limited preview di DevDay 2026 akhir September, menurut API changelog OpenAI). OpenAI menargetkan general availability "dalam beberapa minggu ke depan".
Konsepnya sederhana: Anda mengirim evidence (teks, gambar, atau keduanya) plus daftar pertanyaan yang didefinisikan dengan tipe jawabannya. Yang kembali bukan paragraf — melainkan jawaban terstruktur sesuai tipe yang Anda minta.
Beberapa fakta kunci yang terverifikasi per Oktober 2026:
- Satu-satunya model yang didukung saat beta adalah
gpt-6-luna, varian low-cost dari keluarga GPT-6. Context window-nya tercatat 1.050.000 token. - Harga: $0,10 per 1 juta token input. Output, cache read, dan cache write gratis — tidak ditagih sama sekali.
- Klaim kecepatan: OpenAI menyatakan endpoint ini mengembalikan jawaban terstruktur "sekitar 10x lebih cepat" dibanding Responses API. Catatan jujur: angka ini berasal dari OpenAI sendiri dan belum ada benchmark independen atau angka akurasi head-to-head yang dipublikasikan — jadi perlakukan sebagai klaim vendor, bukan fakta terukur.
- Gambar harus inline base64 data URL. URL gambar yang di-host maupun file ID yang di-upload ditolak — sesuatu yang perlu Anda rencanakan di arsitektur upload Anda.
- Kepatuhan: mendukung Zero Data Retention (ZDR) dan memenuhi syarat HIPAA untuk pelanggan yang eligible, dengan pemrosesan data di AS dan Eropa (EEA/Swiss). Ini membuatnya masuk akal untuk alur moderasi dan gating yang sebelumnya harus merangkai prompt JSON-schema di Chat Completions.
- Kompetitor langsung: TypeSafe AI merilis Jev (early access 15 September 2026, tersebar lewat Vercel AI Gateway) — decision model sejenis seharga $0,042 per 1 juta token input. Untuk 1 juta klasifikasi @ 500 token, biayanya sekitar $21 di Jev versus $50 di OpenAI. Lagi-lagi: belum ada perbandingan akurasi head-to-head yang dipublikasikan kedua vendor.
Intinya: ini bukan model baru. Ini adalah interface baru di atas gpt-6-luna yang memotong langkah generation sepenuhnya — model mengevaluasi evidence dan langsung mengembalikan data terstruktur.
Tiga Tipe Pertanyaan: Predicate, Choice, Score
Inilah inti API-nya. Setiap pertanyaan yang Anda ajukan harus bertipe salah satu dari tiga ini. Memahami ketiganya dengan benar menentukan apakah implementasi Anda elegan atau berantakan.
1. Predicate — "Seberapa yakin kondisi ini benar?"
Predicate mengevaluasi satu kondisi dan mengembalikan probabilitas 0 sampai 1 bahwa kondisi tersebut benar. Ini adalah pengganti langsung untuk semua prompt "jawab true/false".
Contoh kasus nyata: verifikasi klaim kerusakan produk dari foto.
{
  "model": "gpt-6-luna",
  "input": {
    "text": "Klaim pelanggan: 'Layar HP retak saat paket diterima.' Foto paket yang diunggah terlampir.",
    "images": ["data:image/jpeg;base64,/9j/4AAQSkZJRg..."]
  },
  "questions": [
    {
      "name": "visible_damage",
      "type": "predicate",
      "question": "Apakah foto menunjukkan kerusakan fisik yang terlihat pada produk?"
    }
  ]
}
Responsnya (disederhanakan) kira-kira:
{
  "answers": {
    "visible_damage": { "probability": 0.93 }
  }
}
Di kode Anda, ini menjadi branching yang bersih:
const p = answers.visible_damage.probability;
if (p >= 0.85) return approveClaimAuto(claim);
if (p <= 0.15) return rejectClaimAuto(claim);
return escalateToHuman(claim, p); // zona abu-abu
Perhatikan pola dual threshold di atas — bukan satu threshold 0,5. Ini praktik terbaik untuk decision system: zona kepercayaan tinggi diotomatisasi, zona abu-abu dilempar ke manusia. Probabilitas kontinu jauh lebih berguna daripada boolean kaku, karena memungkinkan Anda mengkalibrasi threshold dari data historis.
2. Choice — "Masuk kategori yang mana?"
Choice memilih satu opsi dari daftar tetap, lengkap dengan probabilitas per opsi dan confidence score. Ini pengganti prompt "klasifikasikan ke salah satu kategori berikut".
Contoh: routing tiket support.
{
  "model": "gpt-6-luna",
  "input": {
    "text": "Tiket #4821: 'Saya di-charge dua kali untuk langganan bulan ini, tolong refund salah satunya.'"
  },
  "questions": [
    {
      "name": "queue",
      "type": "choice",
      "question": "Tim mana yang harus menangani tiket ini?",
      "options": ["billing", "technical_support", "account_access", "sales"]
    }
  ]
}
Respons:
{
  "answers": {
    "queue": {
      "choice": "billing",
      "confidence": 0.97,
      "probabilities": {
        "billing": 0.97,
        "technical_support": 0.02,
        "account_access": 0.01,
        "sales": 0.0
      }
    }
  }
}
Distribusi probabilitas penuh ini emas untuk observabilitas. Anda bisa memonitor: berapa persen routing yang confidence-nya di bawah 0,7 minggu ini? Kalau angkanya naik, mungkin ada pergeseran distribusi tiket (atau kualitas model berubah) — sinyal yang tidak akan Anda dapat dari sekadar label teks.
3. Score — "Seberapa parah, dalam skala berurutan?"
Score menilai input terhadap level berurutan (misalnya 1–5) dan mengembalikan rata-rata tertimbang probabilitas dari indeks level — yang bisa jatuh di antara level diskrit, misalnya 3,4. Ini beda dengan choice: levelnya punya urutan yang bermakna.
Contoh: severity insiden keamanan.
{
  "questions": [
    {
      "name": "severity",
      "type": "score",
      "question": "Seberapa parah insiden keamanan ini?",
      "levels": ["info", "low", "medium", "high", "critical"]
    }
  ]
}
Respons:
{
  "answers": {
    "severity": { "score": 3.4, "level": "high" }
  }
}
Skor kontinu 3,4 memberi Anda granularitas untuk prioritisasi antrean — insiden skor 3,9 ditangani sebelum 3,1 — sesuatu yang hilang kalau Anda cuma dapat label "high".
Tutorial Praktis: Membangun Decision Gate untuk Triase Tiket
Sekarang mari merangkai semuanya menjadi sesuatu yang bisa Anda deploy. Kita akan membangun decision gate: komponen kecil yang duduk di depan pipeline support Anda, mengklasifikasikan setiap tiket masuk, dan memutuskan apakah tiket bisa di-routing otomatis atau perlu review manusia.
Langkah 1: Instalasi dan setup
npm install openai
// lib/decisions.ts
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
});

export interface TicketDecision {
  queue: string;
  confidence: number;
  urgency: number;      // 1-5
  isSpam: number;       // probabilitas 0-1
  action: "auto_route" | "human_review";
}
Langkah 2: Fungsi decision gate
const CONFIDENCE_THRESHOLD = 0.8;
const URGENCY_ESCALATION = 4.0;

export async function triageTicket(
  subject: string,
  body: string
): Promise<TicketDecision> {
  const res = await client.post("/v1/decisions", {
    model: "gpt-6-luna",
    input: {
      text: `Subjek: ${subject}\n\nIsi:\n${body}`,
    },
    questions: [
      {
        name: "queue",
        type: "choice",
        question: "Tim mana yang harus menangani tiket ini?",
        options: ["billing", "technical_support", "account_access", "sales"],
      },
      {
        name: "urgency",
        type: "score",
        question: "Seberapa mendesak tiket ini bagi pelanggan?",
        levels: ["sangat_rendah", "rendah", "normal", "tinggi", "kritis"],
      },
      {
        name: "is_spam",
        type: "predicate",
        question: "Apakah tiket ini spam, promosi, atau bukan permintaan support yang valid?",
      },
    ],
  });

  const a = res.answers;
  const spam = a.is_spam.probability;

  // Spam gate: probabilitas tinggi langsung dibuang ke karantina
  if (spam >= 0.9) {
    await quarantineTicket(subject, body, spam);
    return {
      queue: "spam", confidence: spam,
      urgency: 1, isSpam: spam, action: "auto_route",
    };
  }

  const needsHuman =
    a.queue.confidence < CONFIDENCE_THRESHOLD ||
    a.urgency.score >= URGENCY_ESCALATION ||
    (spam > 0.3 && spam < 0.9); // zona abu-abu spam

  const decision: TicketDecision = {
    queue: a.queue.choice,
    confidence: a.queue.confidence,
    urgency: a.urgency.score,
    isSpam: spam,
    action: needsHuman ? "human_review" : "auto_route",
  };

  // Audit log: SELALU catat verdict + probabilitasnya.
  // Ini yang membuat decision system bisa di-debug dan di-kalibrasi.
  await logDecision({ subject, decision, raw: a });

  return decision;
}
Tiga pertanyaan dalam satu request — ini penting. Anda tidak perlu tiga panggilan API terpisah untuk queue, urgency, dan spam. Satu round-trip, satu penagihan input.
Langkah 3: Versi Python (untuk tim data / ML)
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

def score_lead_quality(company_desc: str, employee_count: int) -> dict:
    """Skor kualitas lead untuk tim sales — contoh score + predicate."""
    resp = client.post(
        "/v1/decisions",
        cast_to=dict,
        body={
            "model": "gpt-6-luna",
            "input": {
                "text": f"Deskripsi perusahaan: {company_desc}\nJumlah karyawan: {employee_count}"
            },
            "questions": [
                {
                    "name": "fit_score",
                    "type": "score",
                    "question": "Seberapa cocok perusahaan ini sebagai pelanggan produk SaaS B2B kami?",
                    "levels": ["tidak_cocok", "kurang", "cukup", "cocok", "sangat_cocok"],
                },
                {
                    "name": "has_budget_signal",
                    "type": "predicate",
                    "question": "Apakah deskripsi menunjukkan sinyal bahwa perusahaan memiliki budget untuk tooling?",
                },
            ],
        },
    )
    answers = resp["answers"]
    return {
        "fit": answers["fit_score"]["score"],
        "budget_probability": answers["has_budget_signal"]["probability"],
    }
Langkah 4: Kalibrasi threshold dari data (jangan asal tebak 0,8)
Threshold seperti 0.8 di contoh di atas seharusnya tidak ditebak — harus diukur. Pola yang benar:
- Kumpulkan 200–500 tiket historis yang sudah dilabeli manusia.
- Jalankan decision gate terhadap semuanya, catat probabilitas vs label benar.
- Plot kurva precision-recall untuk tiap threshold kandidat.
- Pilih threshold yang memenuhi target bisnis Anda (misalnya: "auto-route hanya jika precision ≥ 98%, sisanya ke manusia").
Untuk predicate biner, teknik klasik seperti Platt scaling atau isotonic regression bisa mengkalibrasi probabilitas mentah menjadi probabilitas yang terkalibrasi — penting kalau Anda memakai probabilitas untuk keputusan finansial (misalnya auto-approve refund di bawah nominal tertentu).
Hitung-hitungan Biaya: Kapan Ini Benar-benar Lebih Murah
Mari berhitung dengan angka konkret. Asumsikan Anda memproses 100.000 tiket per bulan, rata-rata 400 token input per tiket.
Pendekatan lama (Responses API + Structured Outputs):
- Input: 100.000 × 400 token = 40 juta token × $0,10/1jt = $4,00
- Output: JSON klasifikasi ~60 token × 100.000 = 6 juta token × $0,50/1jt = $3,00
- Total: ~$7,00/bulan
Decisions API:
- Input: 40 juta token × $0,10/1jt = $4,00
- Output: $0 (tidak ditagih)
- Total: ~$4,00/bulan — hemat ~43%
Kelihatannya kecil dalam dolar, tapi skalakan ke 10 juta request per bulan: $700 vs $400. Dan ini belum menghitung penghematan latensi — kalau klaim 10x OpenAI benar, throughput worker Anda naik drastis tanpa menambah concurrency.
Versus kompetitor: TypeSafe Jev di $0,042/1jt input akan mematok skenario yang sama di ~$1,68/bulan. Lebih murah di atas kertas — tapi ingat, belum ada benchmark akurasi head-to-head yang dipublikasikan, dan Jev berjalan di model proprietary mereka sendiri, bukan gpt-6-luna. Keputusan "murah" tanpa data akurasi adalah spekulasi.
Kapan justru TIDAK lebih murah: kalau request Anda butuh konteks sangat panjang. Decisions API tetap menagih semua token input, dan "regional processing premiums and long-context multipliers still apply" menurut dokumentasi. Untuk dokumen 500 ribu token yang diklasifikasi berulang-ulang, caching dan arsitektur Anda jauh lebih menentukan daripada pilihan endpoint.
Kapan Memakai, Kapan Tidak
Setelah hype-nya reda, ini panduan jujurnya:
Pakai Decisions API ketika:
- Output yang Anda butuhkan memang verdict: kategori, probabilitas, skor. Klasifikasi tiket, moderasi konten, lead scoring, severity rating, quality gate di CI/CD untuk output AI.
- Volume tinggi dan latensi penting. Setiap milidetik yang dihemat dari menghilangkan generation terakumulasi di skala.
- Anda butuh probabilitas terkalibrasi untuk thresholding, bukan sekadar label.
- Alur Anda tunduk pada ZDR/HIPAA — endpoint ini membawa compliance tersebut sejak beta.
Jangan pakai (belum) ketika:
- Anda butuh penjelasan atas keputusan. Decisions API mengembalikan verdict, bukan reasoning. Untuk kasus seperti penolakan klaim asuransi yang wajib dijelaskan ke regulator, Anda tetap butuh model generatif (atau menyimpan evidence + verdict untuk audit).
- Anda butuh model selain
gpt-6-luna. Saat beta, tidak ada pilihan lain. Kalau workload Anda butuh kemampuan reasoning frontier, tunggu GA dan lihat apakah model lain didukung. - Input gambar Anda berupa URL hosted atau file ID. Saat ini hanya base64 inline yang diterima — untuk gambar besar, ini menambah ukuran request secara signifikan (base64 ~33% lebih besar dari biner).
- Anda butuh determinisme mutlak. Ini tetap model probabilistik; threshold dan retry policy tetap wajib.
Catatan arsitektur penting: Decisions API bukan pengganti pipeline Anda — ia adalah satu komponen di dalamnya. Intake, redaksI PII, thresholding, aksi, audit log, dan antrean review manusia tetap Anda yang membangun. Endpoint ini hanya menggantikan bagian "tanya model lalu parse jawabannya" — yang memang bagian paling rapuh dari semuanya.
Pola Arsitektur: Decision Gate di Dalam Pipeline Agentic
Bagi Anda yang membangun AI agents (topik yang sedang panas tahun ini), Decisions API punya peran arsitektural yang menarik: sebagai gerbang keputusan murah di antara langkah-langkah agent yang mahal.
Pola umumnya:
[Agent planner - model mahal]
        │
        ▼
[Decisions API - gpt-6-luna, murah & cepat]
   "Apakah langkah ini aman untuk dieksekusi otomatis?"
   "Apakah hasil tool call ini valid?"
        │
   ┌────┴────┐
   ▼         ▼
[eksekusi]  [minta konfirmasi manusia / retry]
Contoh konkret: agent customer-service Anda men-generate draf refund. Sebelum refund dieksekusi, decision gate bertanya (predicate): "Apakah draf ini mematuhi policy refund perusahaan?" dengan probabilitas. Di atas 0,95 → eksekusi otomatis. Di bawah itu → antrean manusia. Anda mendapatkan guardrail yang latensinya kecil dan biayanya nyaris nol, melindungi aksi yang mahal/berisiko.
Pola kedua: validasi output. Setelah model utama menghasilkan sesuatu (kode, ringkasan, jawaban), decision gate menilai (score): "Seberapa yakin output ini benar?" Skor rendah memicu retry dengan model yang lebih kuat atau prompt yang diperbaiki. Ini jauh lebih murah daripada menjalankan model mahal dua kali untuk self-check.
Checklist Produksi
Sebelum men-deploy decision gate ke produksi, pastikan:
- Kalibrasi threshold dari data historis, bukan angka tebakan. Dokumentasikan precision/recall di tiap threshold.
- Audit log setiap verdict: simpan input (atau hash-nya), pertanyaan, probabilitas, threshold yang dipakai, dan keputusan akhir. Tanpa ini Anda tidak bisa debugging atau memenuhi audit compliance.
- Zona abu-abu selalu ke manusia. Dual threshold (auto-approve di atas X, auto-reject di bawah Y, sisanya review) mengalahkan single threshold dalam hampir semua kasus bisnis.
- Monitor distribusi confidence. Penurunan confidence rata-rata adalah early warning untuk data drift atau perubahan perilaku model.
- Retry & fallback policy. Beta berarti API bisa berubah atau down. Punya fallback ke Responses API + Structured Outputs untuk pertanyaan yang sama.
- Redaksi PII sebelum dikirim. ZDR membantu, tapi jangan kirim data yang tidak perlu sejak awal.
- Hitung ulang ekonomi tiap kuartal. Harga model berubah cepat (lihat betapa agresifnya penurunan harga tahun ini); keputusan arsitektur yang optimal di Oktober belum tentu optimal di Januari.
- Jangan percaya klaim 10x secara buta. Ukur latensi p95 di workload Anda sebelum menjanjikan SLA ke stakeholder.
Takeaway Praktis
- Decisions API (beta, 6 Okt 2026) mengubah pola "prompt chat lalu parse JSON" menjadi verdict terstruktur: probability, choice, atau score — via
POST /v1/decisionsdigpt-6-luna. - Ekonominya nyata untuk klasifikasi bervolume tinggi: $0,10/1jt input, output gratis — tapi hitung dengan angka workload Anda sendiri, dan bandingkan dengan alternatif seperti Jev ($0,042/1jt) dengan catatan belum ada benchmark akurasi head-to-head.
- Tiga tipe pertanyaan = tiga pola desain: predicate untuk gate biner dengan dual threshold, choice untuk routing dengan distribusi probabilitas yang bisa dimonitor, score untuk prioritisasi kontinu.
- Ia adalah komponen, bukan solusi: intake, thresholding, audit log, dan human review tetap tanggung jawab Anda. Yang dihilangkan hanyalah bagian paling rapuh — parsing teks bebas.
- Perlakukan klaim vendor sebagai hipotesis: 10x lebih cepat, akurasi setara — ukur sendiri di workload Anda sebelum komit.
Siklus industri AI 2026 bergerak dari "model yang lebih pintar" ke "sistem yang menyelesaikan pekerjaan lebih cepat dan murah" — dan Decisions API adalah contoh paling literal dari pergeseran itu: bukan tentang apa yang bisa dikatakan model, tapi tentang seberapa cepat ia bisa memutuskan. Untuk developer Indonesia yang membangun produk AI dengan margin tipis dan volume tinggi, itu kabar baik — asal Anda mengukurnya sendiri, bukan menelan klaim marketingnya mentah-mentah.
Bonus Praktis: Skrip Benchmark Sendiri (Ukur, Jangan Percaya)
Karena klaim "10x lebih cepat" belum diverifikasi independen, inilah skrip yang bisa Anda jalankan untuk mengukur di workload Anda sendiri. Idenya sederhana: jalankan N request yang sama lewat Decisions API dan lewat Responses API + Structured Outputs, lalu bandingkan latensi p50/p95 dan total biaya.
// benchmark/decisions-vs-responses.ts
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });
const N = 50;

const SAMPLES = [
  "Tiket: 'Paket saya belum sampai padahal sudah 10 hari.'",
  "Tiket: 'Tolong hapus akun saya dan semua datanya.'",
  "Tiket: 'Apakah ada promo untuk langganan tahunan?'",
  // ... tambah sampai 20-50 sampel realistis dari data Anda
];

async function timeIt(fn: () => Promise<unknown>): Promise<number> {
  const t0 = performance.now();
  await fn();
  return performance.now() - t0;
}

async function viaDecisions(text: string) {
  return client.post("/v1/decisions", {
    model: "gpt-6-luna",
    input: { text },
    questions: [
      {
        name: "queue",
        type: "choice",
        question: "Tim mana yang harus menangani tiket ini?",
        options: ["billing", "technical_support", "account_access", "sales"],
      },
    ],
  });
}

async function viaResponses(text: string) {
  return client.responses.create({
    model: "gpt-6-luna",
    input: `Klasifikasikan tiket berikut ke salah satu: billing, technical_support, account_access, sales.\n\nTiket: ${text}`,
    text: {
      format: {
        type: "json_schema",
        name: "triage",
        schema: {
          type: "object",
          properties: {
            queue: {
              type: "string",
              enum: ["billing", "technical_support", "account_access", "sales"],
            },
          },
          required: ["queue"],
        },
      },
    },
  });
}

function percentile(sorted: number[], p: number): number {
  return sorted[Math.min(sorted.length - 1, Math.floor((p / 100) * sorted.length))];
}

async function main() {
  const dTimes: number[] = [];
  const rTimes: number[] = [];

  for (let i = 0; i < N; i++) {
    const sample = SAMPLES[i % SAMPLES.length];
    dTimes.push(await timeIt(() => viaDecisions(sample)));
    rTimes.push(await timeIt(() => viaResponses(sample)));
    if (i % 10 === 0) console.log(`progress: ${i}/${N}`);
  }

  dTimes.sort((a, b) => a - b);
  rTimes.sort((a, b) => a - b);

  console.table({
    "Decisions API": {
      p50_ms: Math.round(percentile(dTimes, 50)),
      p95_ms: Math.round(percentile(dTimes, 95)),
    },
    "Responses API + Structured Outputs": {
      p50_ms: Math.round(percentile(rTimes, 50)),
      p95_ms: Math.round(percentile(rTimes, 95)),
    },
    speedup_p50: (percentile(rTimes, 50) / percentile(dTimes, 50)).toFixed(2) + "x",
    speedup_p95: (percentile(rTimes, 95) / percentile(dTimes, 95)).toFixed(2) + "x",
  });

  // TODO: bandingkan juga akurasi — labeli 50 sampel secara manual,
  // lalu hitung agreement rate kedua pendekatan terhadap label manusia.
}

main();
Jalankan ini tiga kali di jam berbeda (latensi API berfluktuasi mengikuti beban), dan catat juga agreement rate terhadap label manusia — karena kecepatan tanpa akurasi yang setara adalah downgrade, bukan upgrade. Kalau hasilnya menunjukkan speedup 8–12x dengan agreement rate ±1–2% dari baseline, barulah klaim OpenAI bisa Anda anggap terkonfirmasi untuk workload Anda.
Tips benchmarking yang sering dilupakan: pisahkan warm-up request pertama (koneksi TLS dan cold path), jalankan dengan concurrency yang sama dengan produksi Anda (latensi sequential ≠ latensi di 50 worker paralel), dan ukur dari region yang sama dengan deployment produksi — round-trip Jakarta ke region OpenAI berbeda dengan round-trip dari US-East.
Studi Kasus Mini: E-commerce Indonesia
Mari buat ini konkret dengan skenario yang dekat dengan banyak developer Indonesia: marketplace menengah dengan 2 juta order per bulan, tim support 40 orang yang kewalahan.
Masalah: 30% tiket masuk adalah "di mana paket saya?" (lacak kiriman), 20% komplain kualitas barang, 15% request refund/return, sisanya campuran. Tim support menghabiskan 2–3 menit per tiket hanya untuk membaca dan me-routing manual.
Solusi dengan decision gate:
- Triage otomatis (choice): setiap tiket diklasifikasikan ke
lacak_paket,komplain_kualitas,refund_return,akun_pembayaran,lainnya. Confidence ≥ 0,85 dan bukan kategori sensitif → auto-route ke antrean yang benar. Di bawah itu → antrean "butuh baca manusia". - Deteksi urgensi (score): tiket dengan kata-kata seperti "lapor polisi", "viral", "media" mendapat skor urgensi tinggi → langsung naik ke supervisor, bukan antrean FIFO.
- Filter spam/penipuan (predicate): probabilitas "tiket ini upaya social engineering" di atas 0,9 → karantina + flag ke tim fraud.
Angka kasarnya: 500 ribu tiket/bulan × ~350 token = 175 juta token input × $0,10/1jt = $17,50/bulan untuk seluruh triase. Bandingkan dengan biaya satu orang support — ROI-nya bahkan tidak perlu dihitung serius. Penghematan sebenarnya bukan token, melainkan 2–3 menit waktu manusia per tiket yang sekarang dialihkan ke kasus yang benar-benar butuh empati dan judgment.
Yang tetap manual: keputusan refund di atas nominal tertentu, kasus fraud yang ambigu, dan semua yang menyentuh emosi pelanggan yang marah besar. Decision gate memindahkan manusia dari pekerjaan routing ke pekerjaan menyelesaikan — dan itu perbedaan besar untuk morale tim support.
FAQ Singkat
Apakah Decisions API menggantikan Structured Outputs? Tidak. Structured Outputs tetap Anda butuhkan ketika output-nya kompleks (objek nested, array, ekstraksi entitas). Decisions API menang untuk verdict sederhana: satu probabilitas, satu pilihan, satu skor — dengan latensi dan biaya lebih rendah.
Bisakah dipakai untuk bahasa Indonesia?
Ya — gpt-6-luna adalah model multilingual dan question/input berupa teks bebas, jadi prompt berbahasa Indonesia bekerja normal. Untuk akurasi klasifikasi tiket berbahasa Indonesia yang penuh singkatan ("gan", "min", "cod"), uji dengan sampel data Anda sendiri; singkatan dan bahasa gaul adalah sumber misklasifikasi yang umum.
Bagaimana dengan data residency untuk perusahaan Indonesia? OpenAI menyebut pemrosesan regional hanya untuk AS dan Eropa. Jika perusahaan Anda tunduk pada persyaratan penyimpanan data di Indonesia (misalnya sektor keuangan di bawah regulasi OJK/BI), lakukan privacy check terlebih dahulu — API ini mungkin belum memenuhi kebutuhan compliance Anda, terlepas dari fitur ZDR-nya.
Apakah akan tetap murah setelah GA?
Harga beta bukan janji harga GA. OpenAI "mengharapkan GA dalam beberapa minggu ke depan" — pantau changelog harga. Arsitektur yang baik mengisolasi pemanggilan decision di satu modul (seperti lib/decisions.ts di atas) sehingga ganti provider — ke Jev atau lainnya — hanya menyentuh satu file.
Kapan saya harus pindah dari pendekatan lama? Ketika tiga kondisi terpenuhi: (1) Anda sudah mengukur dan speedup-nya signifikan di workload Anda, (2) agreement rate vs label manusia setara dengan baseline, dan (3) Anda punya fallback ke Responses API kalau endpoint beta ini bermasalah. Jangan migrasi atas dasar press release.
Artikel ini ditulis berdasarkan dokumentasi beta OpenAI, API changelog, dan liputan per 6–12 Oktober 2026. Decisions API masih dalam public beta — verifikasi ulang sebelum dipakai untuk keputusan bisnis yang kritis, dan ukur sendiri angka latensi serta akurasinya di workload Anda.